
Visão Computacional e Sistemas Inteligentes de Reconhecimento na transformação digital
A Visão Computacional e os Sistemas Inteligentes de Reconhecimento ocupam uma posição estratégica no desenvolvimento de aplicações capazes de interpretar informações visuais. Nesse contexto, computadores, câmeras e algoritmos de inteligência artificial passaram a trabalhar conjuntamente para identificar padrões, objetos, características, movimentos e situações presentes em imagens e vídeos.
Além disso, essa tecnologia amplia significativamente a capacidade dos sistemas digitais de compreender ambientes físicos. Enquanto uma aplicação tradicional depende de informações estruturadas previamente, um sistema de visão computacional pode receber uma fotografia, um quadro de vídeo ou uma sequência de imagens e transformar elementos visuais em dados que podem ser processados por algoritmos.
Por outro lado, compreender esse processo exige observar que uma imagem digital não é simplesmente uma fotografia armazenada no computador. Na prática, ela representa uma matriz de valores numéricos. Cada pixel contém informações que podem representar intensidade luminosa, cores e outras características utilizadas pelos algoritmos para identificar padrões.
Consequentemente, a Visão Computacional e os Sistemas Inteligentes de Reconhecimento dependem de uma cadeia tecnológica que envolve aquisição de imagens, processamento, extração de características, classificação, reconhecimento e tomada de decisão. Portanto, o resultado final depende tanto da qualidade dos dados quanto dos modelos utilizados.
Como funciona a Visão Computacional e os Sistemas Inteligentes de Reconhecimento
Inicialmente, um sistema precisa obter os dados visuais. Para isso, podem ser utilizadas câmeras convencionais, câmeras industriais, dispositivos móveis, sensores especializados e equipamentos capazes de produzir imagens em diferentes condições.
Em seguida, os dados capturados passam por uma etapa de preparação. Nessa fase, operações como redimensionamento, normalização, redução de ruído, alteração de contraste e conversão de espaço de cores podem ser utilizadas para tornar a informação mais adequada ao processamento.
Posteriormente, algoritmos analisam os padrões presentes na imagem. Dependendo da aplicação, essa análise pode envolver detecção de objetos, classificação de imagens, segmentação, reconhecimento facial, reconhecimento de caracteres, identificação de defeitos industriais ou interpretação de cenas.
Assim, o sistema transforma uma representação visual em informação estruturada. Por exemplo, uma fotografia contendo um veículo pode ser processada até que o software consiga identificar que determinado conjunto de pixels possui características compatíveis com um automóvel.
Como resultado, a saída pode ser representada por categorias, coordenadas, probabilidades, máscaras de segmentação ou outros tipos de dados. Dessa maneira, uma imagem deixa de ser apenas conteúdo visual e passa a funcionar como fonte de informação computacional.
Elementos fundamentais da Visão Computacional Inteligente
Primeiramente, a aquisição de dados constitui uma das etapas mais importantes. Uma câmera com baixa resolução, iluminação inadequada ou posicionamento incorreto pode gerar imagens difíceis de interpretar, mesmo quando o algoritmo utilizado apresenta elevada capacidade.
Além disso, o pré-processamento exerce influência direta sobre a qualidade da análise. Técnicas matemáticas podem reduzir ruídos e destacar características relevantes. Entretanto, um processamento excessivo também pode eliminar informações importantes, razão pela qual essa etapa precisa ser planejada conforme o problema.
Em seguida, ocorre a extração ou aprendizagem de características. Em sistemas clássicos, determinadas características podem ser calculadas explicitamente. Já em modelos modernos baseados em aprendizagem profunda, redes neurais podem aprender representações diretamente a partir dos dados de treinamento.
Por conseguinte, a classificação ou detecção transforma essas representações em resultados interpretáveis. Um modelo pode, por exemplo, receber uma imagem e indicar probabilidades associadas às categorias aprendidas durante o treinamento.
Finalmente, uma camada de decisão utiliza os resultados obtidos. Essa camada pode simplesmente apresentar informações ao usuário ou integrar o reconhecimento a outro sistema. Dessa forma, visão computacional pode fazer parte de sistemas maiores de automação, monitoramento, análise ou controle.
Principais aplicações da Visão Computacional e Sistemas Inteligentes de Reconhecimento
Atualmente, as aplicações são amplas e abrangem setores industriais, comerciais, científicos e tecnológicos. Na indústria, por exemplo, câmeras podem verificar produtos em linhas de produção, identificar irregularidades e auxiliar no controle de qualidade.
Da mesma forma, no setor de transportes, sistemas visuais podem analisar veículos, placas, faixas de circulação e determinados padrões presentes nas vias. Entretanto, aplicações desse tipo precisam considerar legislação, privacidade, segurança e limitações técnicas.
Além disso, na medicina e na pesquisa biomédica, algoritmos podem auxiliar profissionais na análise de imagens médicas. Nesse cenário, a tecnologia deve ser compreendida como ferramenta de apoio e não como substituta automática do conhecimento especializado.
Por outro lado, o varejo pode utilizar visão computacional para análise de produtos, organização de estoques, automação de processos e experiências digitais. Consequentemente, a combinação entre sensores, software e inteligência artificial permite construir aplicações cada vez mais automatizadas.
No setor agrícola, câmeras e sensores podem contribuir para identificar características de plantas, acompanhar condições de cultivos e detectar padrões que merecem avaliação. Assim, informações visuais podem ser integradas a sistemas de gestão e análise de dados.
Detecção de objetos, classificação e segmentação
Primeiramente, é necessário diferenciar três tarefas bastante comuns. A classificação procura determinar qual categoria está associada a uma imagem ou região analisada. Por exemplo, um modelo pode indicar se uma imagem pertence à categoria “carro”, “bicicleta” ou “ônibus”.
Enquanto isso, a detecção de objetos procura identificar onde determinados objetos aparecem na imagem. Nesse caso, o resultado pode conter caixas delimitadoras, classes e valores de confiança.
Já a segmentação apresenta uma análise ainda mais detalhada. Em vez de simplesmente indicar uma caixa ao redor do objeto, o sistema pode determinar quais pixels pertencem a determinada região.
Consequentemente, essas três abordagens possuem finalidades diferentes. Uma aplicação simples pode utilizar classificação, enquanto uma solução que precisa localizar vários elementos simultaneamente pode depender de detecção ou segmentação.
Aprendizado de máquina e redes neurais
Nesse cenário, o aprendizado de máquina tornou-se um componente fundamental. Em vez de programar manualmente todas as regras necessárias para reconhecer determinado padrão, pode-se utilizar um conjunto de dados para treinar um modelo.
Além disso, as redes neurais profundas possibilitaram avanços importantes na análise de imagens. Arquiteturas convolucionais, por exemplo, conseguem aprender representações hierárquicas nas quais diferentes camadas podem responder a padrões de complexidade crescente.
Inicialmente, algumas camadas podem responder a características visuais simples. Depois, camadas posteriores podem combinar essas informações para representar formas, estruturas e padrões mais complexos.
Entretanto, desempenho elevado não significa ausência de limitações. Um modelo pode apresentar resultados diferentes quando recebe imagens muito distintas das utilizadas durante seu treinamento. Por isso, qualidade e diversidade dos dados são fatores essenciais.
Tabela comparativa das principais tarefas
| Tarefa | Objetivo | Resultado típico | Aplicação |
|---|---|---|---|
| Classificação | Identificar uma categoria | Classe e probabilidade | Classificação de imagens |
| Detecção | Localizar objetos | Caixa, classe e confiança | Monitoramento visual |
| Segmentação | Separar regiões | Máscara de pixels | Análise detalhada |
| Reconhecimento de caracteres | Interpretar texto visual | Texto extraído | Digitalização |
| Reconhecimento facial | Comparar características faciais | Correspondência probabilística | Sistemas autorizados |
| Rastreamento | Acompanhar objetos | Trajetória | Análise de vídeo |
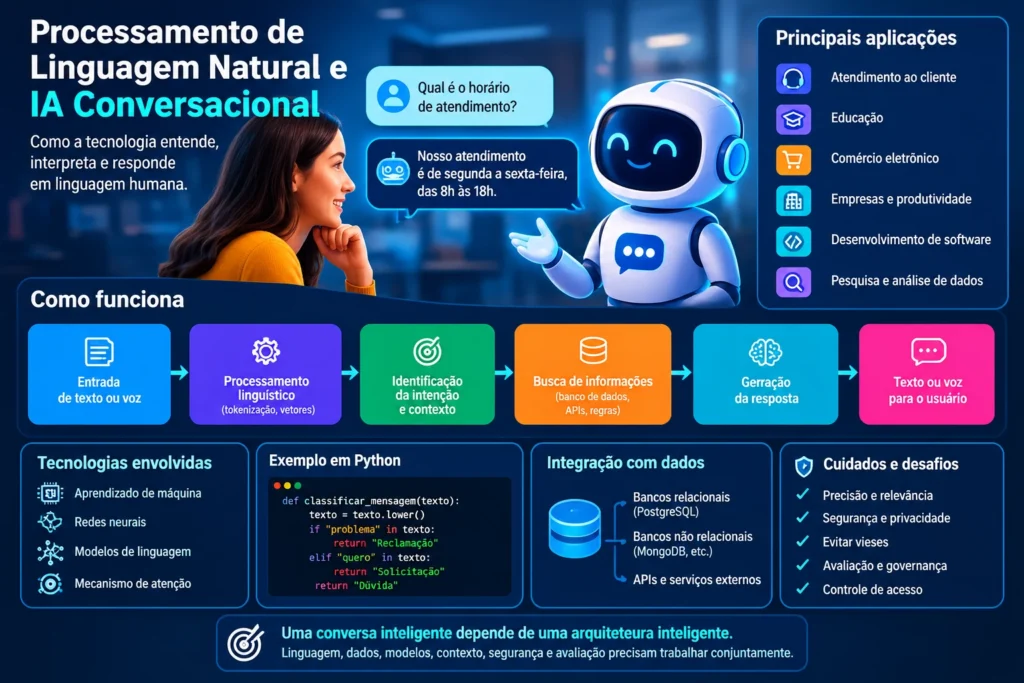
Você também pode se interessar por: https://digitalterritory.com.br/processamento-de-linguagem-natural-e-ia-conversacional/
Dados, treinamento e qualidade dos modelos
Primeiramente, um sistema inteligente depende dos dados utilizados para desenvolvimento e avaliação. Se os exemplos de treinamento forem limitados, inconsistentes ou inadequados, o modelo poderá apresentar comportamento pouco confiável.
Além disso, é necessário separar dados de treinamento, validação e teste de maneira apropriada. Essa separação ajuda a avaliar se o modelo consegue generalizar para informações que não foram utilizadas diretamente durante o aprendizado.
Por conseguinte, métricas também precisam ser escolhidas de acordo com a tarefa. Acurácia, precisão, revocação, F1-score e matriz de confusão podem fornecer diferentes perspectivas sobre o comportamento de um classificador.
Entretanto, uma única métrica raramente explica todo o desempenho. Em determinadas aplicações, falsos positivos podem ser mais problemáticos; em outras, falsos negativos podem representar o principal risco.
EXEMPLO PRÁTICO:
ALERTA DE SEGURANÇA: se você quiser executar os exemplos deste artigo, utilize um ambiente seguro, previamente destinado a testes, com arquivos e dados autorizados. Não utilize imagens, dados pessoais ou sistemas de terceiros sem autorização. A utilização dos códigos e a responsabilidade pelo ambiente de execução são inteiramente do usuário.
Primeiramente, podemos considerar uma aplicação didática que recebe uma imagem e apresenta informações básicas sobre suas propriedades. Esse exemplo não pretende criar um sistema profissional de reconhecimento, mas demonstrar como uma aplicação pode iniciar o fluxo de processamento visual.
Exemplo em Python
Em Python, bibliotecas especializadas podem ser utilizadas para carregar imagens e realizar operações de visão computacional. O código abaixo apresenta uma estrutura simples utilizando OpenCV para abrir uma imagem e mostrar suas dimensões.
import cv2

# Carrega a imagem autorizada para teste
imagem = cv2.imread("imagem_teste.jpg")

if imagem is None:
    raise FileNotFoundError("Imagem não encontrada.")

# Obtém altura, largura e número de canais
altura, largura, canais = imagem.shape

print("Altura:", altura)
print("Largura:", largura)
print("Canais:", canais)

# Exibe a imagem
cv2.imshow("Imagem de teste", imagem)
cv2.waitKey(0)
cv2.destroyAllWindows()
Em seguida, o programa demonstra uma ideia fundamental: antes de aplicar reconhecimento ou classificação, o sistema precisa conseguir acessar e interpretar corretamente a representação digital da imagem.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL
Exemplo em Java
Da mesma forma, Java pode ser utilizado na construção de aplicações que trabalham com imagens. Uma abordagem simples consiste em utilizar classes da biblioteca padrão para carregar uma imagem e consultar suas dimensões.
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;

public class AnaliseImagem {

    public static void main(String[] args) {
        try {
            File arquivo = new File("imagem_teste.jpg");
            BufferedImage imagem = ImageIO.read(arquivo);

            if (imagem == null) {
                throw new IOException("Arquivo de imagem inválido.");
            }

            System.out.println("Largura: " + imagem.getWidth());
            System.out.println("Altura: " + imagem.getHeight());
            System.out.println("Tipo: " + imagem.getType());

        } catch (IOException e) {
            System.err.println("Erro ao carregar imagem: " + e.getMessage());
        }
    }
}
Assim, o exemplo evidencia que a linguagem Java também pode participar de soluções de processamento visual, principalmente quando integrada a bibliotecas específicas de visão computacional e inteligência artificial.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL
Exemplo em JavaScript
Por outro lado, JavaScript apresenta grande utilidade quando a visão computacional precisa ser integrada a interfaces web. No navegador, a aplicação pode trabalhar com elementos HTML e, mediante bibliotecas apropriadas, realizar processamento diretamente no ambiente do usuário.
const entrada = document.createElement("input");
entrada.type = "file";
entrada.accept = "image/*";

entrada.addEventListener("change", () => {
    const arquivo = entrada.files[0];

    if (!arquivo) {
        console.log("Nenhuma imagem selecionada.");
        return;
    }

    const imagem = new Image();

    imagem.onload = () => {
        console.log("Largura:", imagem.width);
        console.log("Altura:", imagem.height);
        console.log("Arquivo:", arquivo.name);
    };

    imagem.src = URL.createObjectURL(arquivo);
});

document.body.appendChild(entrada);
Dessa maneira, o navegador pode servir como ponto inicial para aplicações de análise visual. Entretanto, recursos avançados normalmente exigem bibliotecas ou modelos específicos capazes de executar inferência no ambiente escolhido.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL
Os três códigos foram revisados 4 vezes, considerando sintaxe, coerência, tratamento básico de erros e compatibilidade conceitual com o objetivo didático apresentado.
Banco de dados em sistemas de reconhecimento visual
Além disso, aplicações reais normalmente precisam armazenar informações associadas aos resultados das análises. Nesse cenário, bancos de dados podem registrar identificadores, horários, classes detectadas, probabilidades, caminhos de arquivos e informações relacionadas ao processamento.
Para volumes estruturados e relacionamentos bem definidos, um banco de dados relacional pode ser apropriado. PostgreSQL, por exemplo, oferece recursos robustos para consultas, integridade e organização de dados relacionais.
Entretanto, imagens propriamente ditas podem ser armazenadas de diferentes maneiras. Dependendo da arquitetura, pode-se manter os arquivos em armazenamento específico e registrar no banco apenas os metadados e referências.
Por conseguinte, a decisão entre banco relacional e não relacional deve considerar volume, estrutura, consultas, consistência, escalabilidade e arquitetura geral da aplicação.
Backend Python com banco relacional
A seguir, apresenta-se um exemplo simplificado de backend utilizando Python e SQLite. Para um protótipo local, SQLite pode ser suficiente porque não exige um servidor separado.
import sqlite3
from datetime import datetime

# Banco relacional adequado para protótipos locais.
# Para sistemas maiores, PostgreSQL pode ser considerado.

conexao = sqlite3.connect("visao_computacional.db")
cursor = conexao.cursor()

cursor.execute("""
CREATE TABLE IF NOT EXISTS reconhecimentos (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    classe TEXT NOT NULL,
    confianca REAL NOT NULL,
    data_hora TEXT NOT NULL
)
""")

cursor.execute("""
INSERT INTO reconhecimentos
(classe, confianca, data_hora)
VALUES (?, ?, ?)
""", (
    "objeto_teste",
    0.94,
    datetime.now().isoformat()
))

conexao.commit()

cursor.execute("""
SELECT id, classe, confianca, data_hora
FROM reconhecimentos
ORDER BY id DESC
""")

for registro in cursor.fetchall():
    print(registro)

conexao.close()
Assim, o banco registra o resultado de uma análise hipotética. Em um sistema real, a informação poderia ser produzida por um modelo de detecção ou classificação.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL
Frontend HTML, CSS e JavaScript para localhost
Enquanto isso, uma interface web pode apresentar resultados armazenados ou recebidos por uma API.
<!DOCTYPE html>
<html lang="pt-BR">
<head>
    <meta charset="UTF-8">
    <title>Reconhecimento Visual</title>

    <style>
        body {
            font-family: Arial, sans-serif;
            margin: 40px;
        }

        .resultado {
            border: 1px solid #ccc;
            padding: 20px;
            max-width: 500px;
        }
    </style>
</head>

<body>

    <h1>Resultado do Reconhecimento Visual</h1>

    <div class="resultado">
        <p>Classe: <strong id="classe">Objeto de teste</strong></p>
        <p>Confiança: <strong id="confianca">94%</strong></p>
    </div>

    <script>
        const resultado = {
            classe: "Objeto de teste",
            confianca: 0.94
        };

        document.getElementById("classe").textContent =
            resultado.classe;

        document.getElementById("confianca").textContent =
            `${(resultado.confianca * 100).toFixed(0)}%`;
    </script>

</body>
</html>
Dessa forma, o frontend pode futuramente ser conectado ao backend por meio de uma API HTTP. O fluxo completo poderia envolver navegador, servidor Python, modelo de inteligência artificial e banco de dados.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL
Os códigos relacionados ao banco de dados também foram revisados 4 vezes, considerando estrutura, coerência, tratamento básico e finalidade didática.
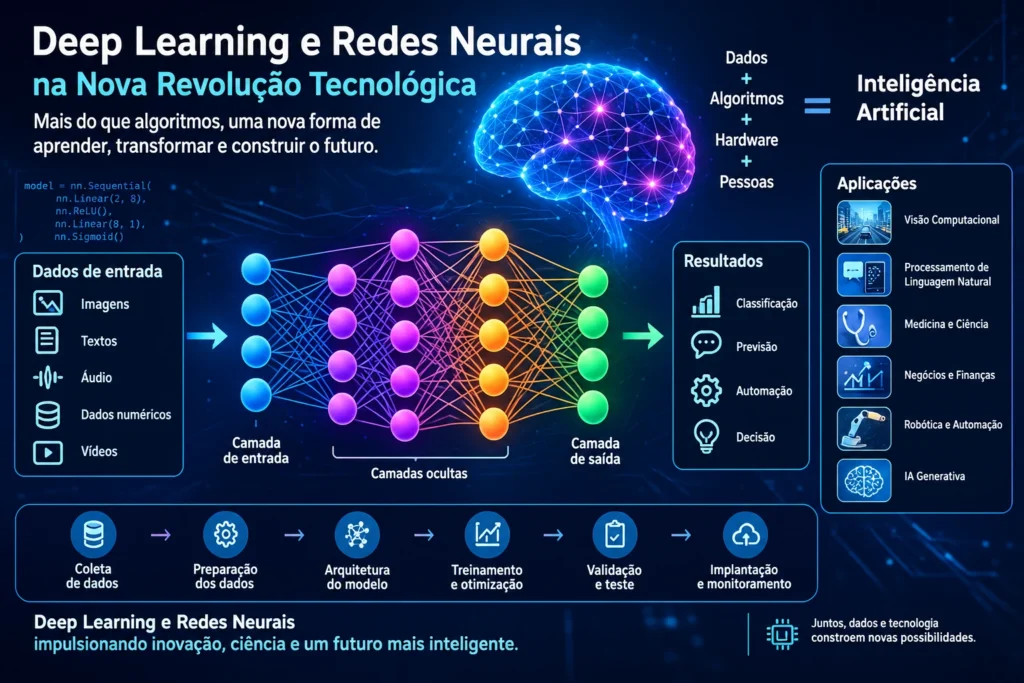
Você também pode se interessar por: https://digitalterritory.com.br/deep-learning-e-redes-neurais-a-base-da-nova-transformacao-tecnologica/
Fluxograma da Visão Computacional e Sistemas Inteligentes de Reconhecimento
O funcionamento pode ser representado conceitualmente pelo seguinte fluxo:
┌──────────────────────┐
│ Aquisição da imagem  │
└──────────┬───────────┘
           ↓
┌──────────────────────┐
│ Pré-processamento    │
│ normalização/ruído   │
└──────────┬───────────┘
           ↓
┌──────────────────────┐
│ Extração/aprendizado │
│ de características   │
└──────────┬───────────┘
           ↓
┌──────────────────────┐
│ Modelo inteligente   │
│ classificação/       │
│ detecção/segmentação │
└──────────┬───────────┘
           ↓
┌──────────────────────┐
│ Resultado             │
│ classe/objeto/máscara │
└──────────┬───────────┘
           ↓
┌──────────────────────┐
│ Decisão ou aplicação │
└──────────────────────┘
Primeiramente, a câmera ou arquivo fornece a informação visual. Em seguida, o sistema prepara os dados. Depois, o modelo processa as características aprendidas e produz um resultado. Finalmente, a aplicação utiliza essa informação conforme sua finalidade.
Gráficos, vetores e conceitos matemáticos
Para compreender uma imagem digital, é útil imaginar cada pixel como uma posição em uma matriz. Em uma imagem em escala de cinza, por exemplo, podemos representar a intensidade por uma função:
I(x, y)
Nesse caso, x representa a posição horizontal e y representa a posição vertical. O valor retornado pela função representa a intensidade do pixel.
Além disso, uma imagem colorida pode ser representada por diferentes canais. Em um modelo RGB, podemos representar o pixel como:
P(x,y) = [R(x,y), G(x,y), B(x,y)]
Consequentemente, cada posição da imagem contém um vetor de três componentes. Essa representação permite que algoritmos matemáticos trabalhem com informações visuais.
Gráfico conceitual de classificação
Um modelo pode receber determinadas características representadas em um plano cartesiano:
        eixo Y
          ↑
          │        ● ●
          │      ● ● ●
          │
          │
          │   ▲ ▲ ▲
          │ ▲ ▲ ▲
          └────────────────→ eixo X
Nesse exemplo conceitual, círculos e triângulos representam grupos diferentes. O objetivo de um classificador é aprender uma fronteira capaz de separar os grupos com base nas características disponíveis.
Por outro lado, modelos reais podem trabalhar com centenas, milhares ou milhões de características, tornando a representação visual impossível em duas dimensões. Ainda assim, o conceito de espaço de características permanece fundamental.
Função de confiança
Um sistema de reconhecimento pode produzir uma estimativa:
C ∈ [0,1]
Quanto mais próximo de 1 estiver o valor, maior poderá ser a confiança matemática atribuída pelo modelo àquela previsão. Entretanto, confiança do modelo não significa necessariamente certeza real.
Por isso, uma saída de 0,94 deve ser interpretada como uma pontuação produzida pelo modelo, e não como uma garantia absoluta de que a classificação esteja correta.
Desafios da Visão Computacional e Sistemas Inteligentes de Reconhecimento
Primeiramente, iluminação representa um desafio importante. Uma mesma cena pode apresentar características completamente diferentes durante o dia, à noite ou sob iluminação artificial.
Além disso, objetos podem aparecer parcialmente ocultos. Esse fenômeno, conhecido como oclusão, dificulta a identificação porque o modelo recebe apenas parte das características disponíveis.
Da mesma forma, mudanças de escala, rotação, perspectiva e distância podem alterar significativamente a aparência dos objetos.
Por conseguinte, sistemas robustos precisam ser avaliados em condições variadas. Um modelo que funciona apenas em um ambiente controlado pode apresentar desempenho muito diferente quando colocado em situações reais.
Privacidade, segurança e responsabilidade
Além dos desafios técnicos, aplicações de reconhecimento visual também envolvem questões jurídicas, éticas e de segurança. Dados visuais podem conter informações pessoais e, portanto, precisam ser tratados conforme a finalidade e as regras aplicáveis.
Nesse sentido, princípios de segurança devem fazer parte da arquitetura desde o início. Controle de acesso, proteção dos dados, registro de operações, minimização de informações e políticas claras de retenção podem reduzir riscos.
Da mesma maneira, sistemas de reconhecimento não devem ser considerados infalíveis. Resultados automatizados precisam ser avaliados de acordo com o contexto, especialmente quando decisões relevantes dependem dessas informações.
Como desenvolver um projeto de Visão Computacional
Inicialmente, é recomendável definir claramente o problema. Antes de escolher uma rede neural ou biblioteca, deve-se determinar o que exatamente precisa ser reconhecido.
Em seguida, é necessário avaliar os dados disponíveis. Quantidade, qualidade, diversidade, resolução e representatividade são fatores importantes.
Posteriormente, pode-se escolher uma arquitetura compatível com o problema. Aplicações simples podem utilizar técnicas tradicionais, enquanto tarefas complexas podem demandar modelos de aprendizado profundo.
Depois disso, o modelo deve ser treinado, validado e testado. Métricas adequadas devem ser analisadas e erros devem ser investigados.
Finalmente, a aplicação pode ser integrada ao sistema de produção. Mesmo nessa etapa, o trabalho não termina, pois modelos podem precisar de monitoramento, atualização e reavaliação conforme os dados mudam.
O futuro da Visão Computacional e Sistemas Inteligentes de Reconhecimento
Atualmente, a tendência é integrar visão computacional com outros componentes de inteligência artificial. Sistemas multimodais podem combinar informações visuais, textuais e outras fontes de dados para produzir interpretações mais completas.
Além disso, dispositivos de borda podem executar determinados modelos diretamente próximos à origem dos dados. Isso pode reduzir latência e diminuir a necessidade de transmitir continuamente imagens para servidores remotos.
Por outro lado, modelos cada vez mais eficientes também podem ampliar aplicações em dispositivos com recursos limitados. Dessa maneira, smartphones, câmeras inteligentes, equipamentos industriais e sistemas embarcados podem executar tarefas anteriormente restritas a infraestruturas mais robustas.
Consequentemente, a evolução dessa área tende a aproximar percepção computacional, automação e tomada de decisão baseada em dados.
Conclusão
Portanto, a Visão Computacional e os Sistemas Inteligentes de Reconhecimento representam uma combinação entre processamento de imagens, inteligência artificial, aprendizado de máquina, matemática e engenharia de software.
Assim, compreender essa tecnologia exige observar todo o ciclo, desde a captura da imagem até a interpretação do resultado. Uma aplicação eficiente não depende apenas de um algoritmo sofisticado, mas também da qualidade dos dados, da arquitetura, da infraestrutura e da correta avaliação dos resultados.
Além disso, aplicações profissionais precisam considerar segurança, privacidade, manutenção e responsabilidade. Afinal, transformar uma imagem em informação útil envolve uma cadeia tecnológica complexa, na qual erros em qualquer etapa podem comprometer o resultado final.
Por fim, Visão Computacional e Sistemas Inteligentes de Reconhecimento continuará sendo um tema relevante para profissionais de tecnologia porque permite conectar o mundo físico ao processamento inteligente de dados. Dessa maneira, câmeras e sensores deixam de atuar apenas como instrumentos de captura e passam a integrar sistemas capazes de analisar padrões, produzir informações e apoiar processos automatizados.
Resumo
Em síntese, a Visão Computacional e os Sistemas Inteligentes de Reconhecimento permitem que computadores processem informações visuais por meio de imagens e vídeos. O processo normalmente envolve aquisição, pré-processamento, extração ou aprendizagem de características, classificação, detecção, segmentação e tomada de decisão.
Além disso, aplicações podem ser desenvolvidas com Python, Java e JavaScript, enquanto bancos de dados podem armazenar resultados e metadados associados às análises. A escolha da arquitetura depende do problema, do volume de informações e dos requisitos de desempenho.
Por fim, modelos inteligentes precisam ser avaliados com métricas adequadas e utilizados com responsabilidade, especialmente quando trabalham com informações potencialmente sensíveis.
NOTA TÉCNICA
Visão Computacional • Inteligência Artificial • Reconhecimento • Imagens • Pixels • Classificação • Detecção de Objetos • Segmentação • Redes Neurais • Aprendizado de Máquina • Dados • Inferência • Python • Java • JavaScript • Banco de Dados • API • Segurança • Privacidade • Métricas • Automação