
A proteção dos sistemas que sustentam a sociedade moderna
A cibersegurança avançada para infraestruturas críticas tornou-se uma prioridade estratégica para organizações que operam serviços essenciais, pois a transformação digital ampliou a conexão entre sistemas computacionais, equipamentos industriais e processos físicos. Atualmente, redes elétricas, sistemas de abastecimento de água, hospitais, transportes, telecomunicações e instalações industriais dependem de tecnologias capazes de processar informações e coordenar operações continuamente. Consequentemente, proteger esses ambientes exige muito mais do que instalar antivírus ou configurar uma firewall: é necessário integrar pessoas, processos, arquitetura tecnológica, monitoramento e planejamento de continuidade operacional.
Nesse contexto, uma falha digital pode ultrapassar os limites de um computador e afetar serviços utilizados por milhares de pessoas. Por exemplo, uma indisponibilidade em sistemas de controle industrial pode comprometer o acompanhamento de equipamentos, enquanto uma interrupção nas comunicações pode dificultar a coordenação de equipes responsáveis por serviços essenciais. Portanto, a segurança precisa considerar tanto os dados armazenados quanto os efeitos que uma ocorrência cibernética pode produzir no ambiente físico.
Além disso, a expansão da Internet das Coisas, dos serviços em nuvem e das ferramentas de manutenção remota aumentou a quantidade de conexões que precisam ser administradas. Embora essas tecnologias ofereçam eficiência, também introduzem dependências e possíveis caminhos de exposição. Assim, a cibersegurança avançada para infraestruturas críticas deve combinar prevenção, detecção, resposta e recuperação, sempre respeitando os requisitos de segurança física e continuidade dos serviços.
O que são infraestruturas críticas e por que precisam de proteção avançada?
Inicialmente, é importante compreender que uma infraestrutura crítica corresponde a um conjunto de instalações, sistemas, ativos e serviços cuja interrupção ou comprometimento pode provocar consequências relevantes para a sociedade, a economia, a saúde pública ou a segurança coletiva. A classificação exata depende do contexto nacional, da regulamentação aplicável e da importância operacional de cada organização.
Entre os principais setores estão:
- Energia: geração, transmissão e distribuição de eletricidade, além de instalações de produção e transporte de combustíveis.
- Água e saneamento: captação, tratamento, distribuição e monitoramento da qualidade da água.
- Saúde: hospitais, laboratórios, sistemas de atendimento e equipamentos conectados.
- Transportes: ferrovias, aeroportos, sistemas de sinalização e centros de controle de tráfego.
- Telecomunicações: redes de comunicação, infraestrutura de conectividade e serviços essenciais de transmissão.
- Indústria: fábricas, instalações de processamento e sistemas automatizados de produção.
- Serviços digitais essenciais: centros de processamento de dados e plataformas que sustentam operações estratégicas.
Entretanto, esses setores não funcionam isoladamente. Uma instalação industrial depende de eletricidade e telecomunicações; um hospital precisa de energia, conectividade e abastecimento de água; por sua vez, os centros de controle dependem de sistemas de informação para coordenar atividades. Como resultado, um incidente localizado pode produzir efeitos indiretos em outras organizações.
A publicação NIST SP 800-82 Rev. 3 apresenta orientações específicas para proteger tecnologias operacionais, considerando requisitos próprios de disponibilidade, confiabilidade e segurança. O documento contempla sistemas industriais, automação predial, transportes e outras tecnologias que monitoram ou influenciam processos físicos. CSRC+1
Portanto, a proteção avançada deve começar pela identificação dos serviços essenciais, das dependências tecnológicas e das consequências de uma interrupção. Afinal, não é suficiente saber quais computadores existem: também é necessário entender quais operações dependem deles e como manter os serviços seguros diante de falhas.
A diferença entre segurança da informação e segurança operacional
Embora estejam relacionadas, a segurança da informação e a segurança operacional apresentam prioridades que precisam ser conciliadas.
Na segurança da informação, a confidencialidade, a integridade e a disponibilidade são princípios fundamentais. A confidencialidade restringe o acesso a pessoas autorizadas; a integridade procura preservar a exatidão e a confiabilidade dos dados; enquanto a disponibilidade busca garantir que informações e sistemas permaneçam acessíveis quando necessários.
Em ambientes industriais, contudo, a aplicação desses princípios exige atenção adicional. Um equipamento pode precisar operar continuamente, utilizar protocolos antigos ou depender de uma janela de manutenção limitada. Dessa maneira, uma atualização de software aparentemente simples pode exigir testes, validação técnica e autorização operacional antes de ser implantada.
Por exemplo, em uma instalação de tratamento de água, um sistema de supervisão pode apresentar vulnerabilidades conhecidas. Entretanto, desligá-lo sem planejamento pode prejudicar o acompanhamento do processo. Por conseguinte, a decisão correta não consiste em ignorar a vulnerabilidade nem em aplicar mudanças indiscriminadamente, mas em avaliar o risco, planejar uma intervenção segura e adotar medidas compensatórias enquanto a correção não puder ser realizada.
Outro aspecto relevante é a segurança física. Sistemas automatizados podem influenciar temperatura, pressão, vazão, movimentação de equipamentos e outras variáveis. Assim, uma alteração indevida em um sistema de controle pode gerar consequências operacionais que não existem em uma aplicação convencional de escritório.
Logo, a cibersegurança avançada para infraestruturas críticas precisa unir equipes de tecnologia da informação, engenharia, operações, manutenção e segurança física. Essa colaboração permite avaliar os efeitos de cada medida antes de modificar um ambiente essencial.
Principais ameaças cibernéticas às infraestruturas críticas
As ameaças variam conforme o setor, a arquitetura tecnológica e a capacidade de proteção da organização. Ainda assim, algumas categorias merecem atenção prioritária.
1. Ransomware e indisponibilidade de serviços. Esse tipo de ameaça pode comprometer sistemas, interromper atividades e dificultar o acesso a informações necessárias para a operação. Em uma infraestrutura crítica, os efeitos podem se estender a processos dependentes, equipes de atendimento e serviços externos.
2. Roubo de credenciais. Senhas reutilizadas, autenticação insuficiente e contas sem supervisão podem permitir acessos indevidos. Por isso, a gestão de identidades, a autenticação multifator e a revisão periódica de privilégios são medidas importantes.
3. Vulnerabilidades em equipamentos antigos. Determinados dispositivos industriais permanecem em operação por muitos anos. Como resultado, podem utilizar sistemas sem suporte, componentes desatualizados ou protocolos que não oferecem mecanismos modernos de proteção.
4. Acesso remoto mal configurado. Ferramentas utilizadas por fornecedores e equipes de manutenção ampliam a eficiência, mas também criam pontos que precisam ser protegidos. Consequentemente, acessos remotos devem ser autorizados, limitados, autenticados e registrados.
5. Comprometimento da cadeia de suprimentos. Uma organização pode depender de fabricantes, integradores, prestadores de serviços e bibliotecas de software. Dessa forma, a segurança também depende da capacidade de avaliar fornecedores e acompanhar os riscos associados a componentes externos.
6. Erros humanos e falhas de processo. Configurações incorretas, permissões excessivas, procedimentos desatualizados e respostas improvisadas podem agravar incidentes. Portanto, treinamento e padronização operacional são tão importantes quanto ferramentas tecnológicas.
7. Comprometimento de dispositivos conectados. Sensores, câmeras, controladores e outros equipamentos podem introduzir riscos quando são instalados sem inventário, manutenção ou controle de acesso adequados.
Além dessas ameaças, desastres naturais, falhas elétricas e problemas de telecomunicações podem interagir com incidentes digitais. Por isso, a estratégia precisa considerar riscos cibernéticos e não cibernéticos em um mesmo planejamento de continuidade.
Tecnologias operacionais: SCADA, PLC, ICS e IoT industrial
Para compreender a proteção avançada, é necessário conhecer as principais tecnologias utilizadas no controle e monitoramento de processos físicos.
Os sistemas SCADA permitem supervisionar operações distribuídas, receber informações de equipamentos e apresentar dados aos operadores. São utilizados, por exemplo, em redes de distribuição e instalações industriais geograficamente dispersas.
Os controladores lógicos programáveis (PLCs) executam instruções de controle e interagem com sensores e atuadores. Já os sistemas de controle industrial (ICS) abrangem diferentes componentes e arquiteturas empregados na automação de processos.
Por sua vez, a Internet das Coisas Industrial (IIoT) conecta sensores, equipamentos e plataformas de análise para melhorar a visibilidade operacional, a manutenção e a eficiência.
Essas tecnologias oferecem benefícios expressivos. Entretanto, a integração entre sistemas modernos e equipamentos antigos pode dificultar a aplicação uniforme de controles de segurança. Em consequência, cada ativo precisa ser classificado conforme sua função, suas dependências, suas limitações e os impactos de uma possível falha.
Também é necessário diferenciar monitoramento de controle. Uma ferramenta que apenas recebe informações pode apresentar riscos diferentes de um componente autorizado a modificar parâmetros operacionais. Assim, os privilégios devem acompanhar a função efetivamente necessária, evitando que sistemas de análise tenham permissões de comando sem justificativa.
Arquitetura de segurança: segmentação e defesa em profundidade
Uma arquitetura segura reduz a possibilidade de que o comprometimento de um componente afete todo o ambiente. Nesse sentido, a segmentação de redes separa sistemas conforme sua finalidade, criticidade e necessidade de comunicação.
Em vez de manter todos os dispositivos em uma rede ampla, a organização pode estabelecer zonas controladas para ambientes administrativos, supervisão industrial, equipamentos de controle e serviços de suporte. Entre essas zonas, regras explícitas definem quais comunicações são permitidas e quais precisam ser bloqueadas.
Além disso, uma zona intermediária de serviços, frequentemente chamada de DMZ industrial, pode ajudar a intermediar trocas autorizadas entre redes corporativas e ambientes operacionais. Essa arquitetura deve ser projetada por profissionais qualificados, considerando os requisitos de segurança e disponibilidade do processo.
A defesa em profundidade complementa a segmentação por meio de camadas independentes. Por exemplo, a organização pode combinar autenticação robusta, controle de acesso, proteção de endpoints compatíveis, monitoramento de rede, registros centralizados e procedimentos de recuperação.
Entretanto, a segmentação não deve ser confundida com uma garantia absoluta. Regras mal configuradas, exceções excessivas e conexões temporárias não documentadas podem reduzir sua eficácia. Por conseguinte, as políticas precisam ser revisadas, testadas e mantidas sob controle de mudanças.
Outro princípio importante é o menor privilégio. Cada usuário, aplicação ou equipamento deve receber apenas as permissões necessárias à sua função. Dessa maneira, um incidente envolvendo uma conta específica tende a encontrar menos oportunidades de expansão.
Finalmente, a arquitetura precisa incluir documentação atualizada. Diagramas de rede, inventários, fluxos autorizados e responsáveis por cada sistema ajudam a identificar dependências e tornam as decisões de resposta mais rápidas e consistentes.
Gestão de ativos e vulnerabilidades
Não é possível proteger adequadamente aquilo que a organização desconhece. Portanto, manter um inventário atualizado é uma das primeiras medidas para estabelecer uma estratégia de cibersegurança avançada para infraestruturas críticas.
Esse inventário deve registrar, quando aplicável, a identificação do equipamento, sua localização, seu fabricante, sua versão de software, seu responsável, sua função operacional, suas conexões e sua criticidade. Além disso, precisa documentar restrições de manutenção e dependências importantes.
A orientação conjunta sobre inventário de ativos de tecnologia operacional publicada em 2025 por órgãos de segurança e proteção de infraestrutura destaca a importância desse levantamento para identificar exposições, planejar defesas e responder a incidentes. CISA+1
Em seguida, a organização deve avaliar vulnerabilidades com métodos compatíveis com o ambiente. Embora ferramentas de varredura possam ser úteis em redes corporativas, sua utilização indiscriminada em sistemas industriais pode causar efeitos indesejados. Consequentemente, qualquer teste precisa considerar autorização, documentação do fabricante, impacto operacional e procedimentos de segurança.
Quando uma correção não pode ser aplicada imediatamente, medidas compensatórias podem reduzir a exposição. Entre elas estão restringir conexões, reforçar controles de acesso, ampliar o monitoramento e limitar a comunicação do ativo a sistemas estritamente necessários.
A priorização deve considerar a gravidade técnica, a exposição, a possibilidade de exploração, a importância do ativo e o impacto potencial sobre pessoas e serviços. Assim, uma vulnerabilidade em um componente essencial pode exigir atenção especial mesmo quando sua classificação técnica não for a mais elevada.
Por fim, cada decisão precisa ser documentada, incluindo a justificativa para adiar uma atualização, os controles alternativos adotados, o responsável pela aprovação e a data de reavaliação.
Identidade digital, autenticação e acesso remoto
O gerenciamento de identidades é uma das bases da proteção de ambientes críticos. Afinal, uma conta comprometida pode proporcionar acesso a informações e operações que deveriam permanecer restritas.
Primeiramente, é necessário manter contas individuais sempre que tecnicamente possível. Contas compartilhadas dificultam a atribuição de responsabilidades e a investigação posterior. Além disso, permissões administrativas devem ser concedidas somente quando necessárias e utilizadas de acordo com procedimentos definidos.
A autenticação multifator acrescenta uma camada de verificação, especialmente para acessos administrativos e remotos. Entretanto, sua implantação precisa considerar os equipamentos disponíveis, a continuidade operacional e os métodos de recuperação de contas.
No caso de fornecedores, o acesso deve possuir finalidade definida, prazo autorizado e escopo limitado. Dessa forma, credenciais permanentes sem supervisão podem ser substituídas por mecanismos de acesso controlado, com registro das atividades e encerramento da autorização quando o serviço terminar.
Também convém revisar periodicamente as contas inativas, os privilégios elevados e as permissões de aplicações. Quando um colaborador muda de função ou encerra seu vínculo com a organização, os acessos correspondentes devem ser ajustados conforme o procedimento interno.
Por outro lado, políticas excessivamente rígidas, sem planejamento para emergências, podem dificultar a manutenção de serviços essenciais. Portanto, é necessário estabelecer procedimentos excepcionais seguros, com autorização, rastreabilidade e revisão posterior.
Em síntese, o objetivo não é apenas verificar quem está tentando acessar um sistema, mas garantir que cada identidade seja reconhecida, autorizada e monitorada de acordo com o risco da operação.
Monitoramento contínuo e detecção de anomalias
A prevenção reduz a probabilidade de incidentes, mas não elimina todas as possibilidades de comprometimento. Por isso, a detecção contínua é fundamental para identificar comportamentos inesperados e acelerar a resposta.
Em ambientes corporativos, ferramentas de gerenciamento de informações e eventos de segurança, conhecidas como SIEM, podem consolidar registros de diferentes fontes. Já soluções específicas para ambientes operacionais podem analisar comunicações e comportamentos de rede com atenção aos protocolos e às limitações dos equipamentos industriais.
Além disso, a equipe precisa conhecer o comportamento normal do ambiente. Por exemplo, uma alteração inesperada na comunicação entre dois segmentos pode merecer investigação, especialmente quando não corresponde a uma mudança autorizada.
Contudo, uma anomalia não comprova automaticamente um ataque. Uma manutenção programada, uma falha de sensor ou uma mudança operacional legítima também pode gerar alertas. Consequentemente, os mecanismos de detecção precisam combinar contexto, criticidade, histórico e validação humana.
A qualidade dos registros também é decisiva. Horários sincronizados, fontes identificadas, retenção adequada e proteção contra alterações indevidas ajudam a reconstruir acontecimentos. Dessa maneira, os registros deixam de ser apenas arquivos técnicos e passam a apoiar a investigação, a auditoria e a melhoria contínua.
Para evitar excesso de alertas, a organização deve estabelecer critérios de prioridade. Um evento relacionado a um ativo essencial pode exigir avaliação imediata, enquanto um alerta de baixo impacto pode seguir um fluxo de análise menos urgente.
Por fim, o monitoramento deve possuir responsáveis definidos, procedimentos de escalonamento e métricas que permitam avaliar sua eficácia. Sem essas condições, mesmo uma ferramenta avançada pode produzir muitos dados sem gerar decisões úteis.
Criptografia, integridade e proteção das comunicações
A criptografia protege informações por meio de técnicas matemáticas que tornam os dados ilegíveis para quem não possui as credenciais ou chaves necessárias. Em infraestruturas críticas, ela pode proteger comunicações administrativas, conexões remotas, arquivos sensíveis e informações utilizadas em atividades de manutenção.
Entretanto, nem todos os equipamentos industriais oferecem suporte aos mesmos mecanismos criptográficos. Por essa razão, a implantação precisa considerar compatibilidade, desempenho, gerenciamento de chaves e requisitos de segurança operacional.
A integridade também merece atenção. Assinaturas digitais, verificações criptográficas e mecanismos de validação podem ajudar a identificar alterações não autorizadas em arquivos, atualizações ou configurações, desde que sejam utilizados de maneira adequada.
Além disso, a gestão de chaves deve definir quem pode acessá-las, onde são armazenadas, como são substituídas e o que acontece quando há suspeita de comprometimento. Uma solução criptográfica mal administrada pode criar uma falsa sensação de segurança.
É importante observar, ainda, que criptografia não substitui segmentação, controle de acesso ou monitoramento. Ela protege determinados aspectos da comunicação e dos dados, mas não garante que um sistema autorizado esteja livre de falhas.
Portanto, a escolha das tecnologias deve partir da análise dos riscos, dos requisitos técnicos e das recomendações aplicáveis ao setor. Em ambientes críticos, a implementação precisa ser testada e aprovada antes de alcançar os sistemas de produção.
Inteligência artificial aplicada à cibersegurança avançada
A inteligência artificial pode ampliar a capacidade de análise de grandes volumes de eventos, identificar padrões incomuns e apoiar a priorização de alertas. Nesse sentido, modelos estatísticos e algoritmos de aprendizado de máquina podem ajudar equipes de segurança a reconhecer desvios que seriam difíceis de observar manualmente.
Por exemplo, um sistema de análise pode aprender quais dispositivos costumam se comunicar, em quais períodos e com que frequência. Quando aparece um comportamento diferente, a ferramenta pode gerar um alerta para avaliação humana. Entretanto, esse resultado deve ser interpretado com cautela, pois alterações legítimas de operação também podem produzir desvios estatísticos.
Além disso, a qualidade dos dados influencia diretamente a utilidade desses modelos. Registros incompletos, equipamentos sem identificação e horários inconsistentes podem prejudicar a análise. Portanto, o investimento em inventário, padronização e governança de dados continua indispensável, mesmo quando a organização utiliza inteligência artificial.
Outro ponto importante envolve falsos positivos e falsos negativos. Um falso positivo ocorre quando uma atividade legítima é classificada como suspeita; por sua vez, um falso negativo acontece quando uma atividade perigosa não é identificada. Consequentemente, o desempenho deve ser medido em condições representativas, com testes autorizados e critérios compatíveis com a criticidade operacional.
Em infraestruturas críticas, também é recomendável evitar que uma decisão automatizada de segurança provoque uma alteração física sem supervisão e validação apropriadas. Bloquear uma comunicação, por exemplo, pode interromper uma função necessária ao processo. Assim, ações automáticas devem possuir limites, mecanismos de contingência e avaliação de impacto.
Por fim, a inteligência artificial deve ser tratada como uma ferramenta complementar, e não como substituta da engenharia, da análise de risco ou da experiência dos operadores. Sua contribuição mais valiosa está em melhorar a capacidade de observação e apoiar decisões responsáveis.
Você também pode se interessar por: https://digitalterritory.com.br/criptografia-moderna-e-protecao-de-dados-sensiveis-tecnologias-algoritmos-e-estrategias-de-seguranca-digital/
Segurança em nuvem e integração entre ambientes
A computação em nuvem permite armazenar informações, processar dados e disponibilizar aplicações com flexibilidade. Entretanto, sua integração com infraestruturas críticas exige atenção especial aos limites entre os ambientes corporativos e os sistemas que controlam operações físicas.
Primeiramente, a organização precisa determinar quais dados podem ser enviados para serviços externos, quais requisitos de confidencialidade se aplicam e quais dependências surgiriam em caso de indisponibilidade da conexão. Além disso, deve analisar as condições contratuais, a localização dos dados quando pertinente e as responsabilidades de cada fornecedor.
Uma arquitetura híbrida pode manter funções essenciais localmente enquanto utiliza serviços externos para análises, relatórios e outras atividades compatíveis com o risco. Dessa forma, a perda temporária de conectividade não precisa necessariamente interromper todas as operações.
Todavia, essa separação depende de um projeto bem definido. Cópias de dados, integrações por interfaces de programação e contas de serviço podem criar novas superfícies de exposição. Por conseguinte, cada conexão precisa possuir finalidade documentada, autenticação adequada, permissões limitadas e monitoramento.
Também é necessário avaliar os mecanismos de recuperação. Backups armazenados em ambientes distintos, testes de restauração e procedimentos alternativos podem ajudar a reduzir o impacto de uma falha em serviços externos.
Assim, a decisão entre processamento local, nuvem ou arquitetura híbrida não deve depender apenas do custo. A disponibilidade exigida, a latência, a sensibilidade das informações, a conectividade e a segurança operacional precisam orientar a escolha.
Segurança da cadeia de suprimentos tecnológica
Uma infraestrutura crítica pode depender de equipamentos, softwares, componentes eletrônicos, atualizações e serviços fornecidos por diversas organizações. Consequentemente, a proteção de um ambiente não depende exclusivamente dos controles internos: também exige visibilidade sobre os riscos introduzidos por terceiros.
Inicialmente, é necessário identificar os fornecedores que participam de funções essenciais e compreender quais acessos possuem. Essa análise deve abranger fabricantes, integradores de sistemas, empresas de manutenção e prestadores de suporte remoto.
Além disso, contratos e procedimentos internos podem estabelecer requisitos de notificação de incidentes, gestão de vulnerabilidades, proteção de credenciais e controle de alterações. Essas medidas tornam as responsabilidades mais claras e facilitam a coordenação quando surge um problema.
Outro aspecto importante é a procedência de softwares e atualizações. Organizações devem utilizar canais autorizados, verificar a autenticidade dos pacotes quando houver mecanismos disponíveis e documentar as mudanças realizadas. Desse modo, torna-se mais fácil investigar alterações inesperadas e reconstruir o histórico de manutenção.
Entretanto, nem sempre é possível substituir imediatamente um fornecedor ou equipamento. Em tais circunstâncias, a organização pode avaliar a exposição existente e adotar controles compensatórios, como restrições de comunicação, supervisão adicional e revisão de permissões.
Portanto, a gestão de fornecedores precisa ser contínua. Uma avaliação realizada apenas no momento da contratação pode deixar de refletir mudanças posteriores na tecnologia, no suporte ou no perfil de risco.
Plano de resposta a incidentes cibernéticos
Mesmo com medidas preventivas, uma organização precisa estar preparada para responder a incidentes. Um plano de resposta estabelece responsabilidades, critérios de acionamento, canais de comunicação, procedimentos de análise e condições para a recuperação segura dos serviços.
O primeiro passo é preparar a equipe antes de qualquer ocorrência. Isso inclui manter contatos atualizados, documentar dependências críticas, identificar responsáveis técnicos e estabelecer critérios para comunicar incidentes à administração e às autoridades competentes, conforme as obrigações aplicáveis.
Quando um alerta relevante é identificado, a equipe deve validar as informações e avaliar a extensão potencial do problema. Em seguida, profissionais autorizados precisam determinar quais ações de contenção são apropriadas, considerando tanto a segurança digital quanto a continuidade operacional.
Em ambientes industriais, uma desconexão aparentemente simples pode afetar sensores, sistemas de supervisão ou funções necessárias ao controle de um processo. Por essa razão, medidas de contenção precisam ser coordenadas com os responsáveis pela operação, e não executadas de maneira improvisada.
A investigação deve preservar evidências úteis, incluindo registros, horários, configurações relevantes e informações sobre as alterações realizadas. Além disso, a equipe deve registrar decisões e justificativas para facilitar auditorias e análises posteriores.
A recuperação, por sua vez, não consiste apenas em restaurar arquivos. É necessário verificar a integridade dos sistemas, confirmar que as causas conhecidas foram tratadas, testar as funções essenciais e obter as autorizações necessárias antes de retomar a operação normal.
Finalmente, a organização deve realizar uma análise pós-incidente. Essa avaliação permite identificar lacunas de prevenção, falhas de comunicação e oportunidades de melhoria. O objetivo é transformar a experiência em medidas concretas, sem depender exclusivamente da memória dos participantes.
Continuidade operacional e recuperação de desastres
A continuidade operacional procura manter ou restabelecer funções essenciais durante situações adversas. Já a recuperação de desastres concentra-se nos procedimentos necessários para recuperar sistemas, dados e serviços após uma interrupção relevante.
Embora sejam complementares, essas disciplinas não devem ser reduzidas a um único arquivo de backup. Uma organização pode possuir cópias de dados e, ainda assim, não conseguir retomar a operação por falta de equipamentos, credenciais, documentação ou pessoal qualificado.
Primeiramente, é necessário identificar quais serviços devem ser recuperados prioritariamente. Essa decisão depende do impacto da interrupção, das necessidades da população atendida e das dependências entre os sistemas.
Duas métricas são especialmente úteis:
- RTO (Recovery Time Objective): período máximo de indisponibilidade que a organização pretende tolerar para determinado serviço.
- RPO (Recovery Point Objective): quantidade de perda de dados, expressa em tempo, que pode ser tolerada segundo os objetivos de recuperação.
Por exemplo, uma aplicação administrativa pode admitir uma recuperação mais demorada do que uma função necessária para acompanhar um processo essencial em tempo real. Entretanto, os valores concretos devem ser definidos por análise de impacto e validação operacional, não por uma regra universal.
Além disso, os backups devem possuir controles de acesso, proteção contra alterações indevidas e testes periódicos de restauração. Cópias isoladas de credenciais comprometidas e falhas simultâneas podem melhorar a capacidade de recuperação, desde que a arquitetura seja adequada ao ambiente.
Os exercícios de continuidade também precisam incluir cenários realistas, responsabilidades claras e critérios para declarar uma emergência. Assim, as equipes podem identificar falhas nos procedimentos antes que uma ocorrência verdadeira exija decisões urgentes.
Governança, conformidade e gestão de riscos
A governança transforma a cibersegurança em uma responsabilidade organizacional, em vez de tratá-la como uma tarefa exclusivamente técnica. Para isso, é necessário estabelecer políticas, atribuir responsabilidades, aprovar investimentos e acompanhar resultados.
O NIST Cybersecurity Framework 2.0 oferece uma estrutura para organizar atividades de governança e gestão de riscos cibernéticos. Paralelamente, a publicação NIST SP 800-82 Rev. 3 aborda os requisitos específicos de segurança da tecnologia operacional. CSRC+1
Além disso, as Cybersecurity Performance Goals 2.0 da CISA apresentam práticas fundamentais voltadas à redução de riscos em infraestruturas críticas. Entre os temas contemplados estão governança, inventário de ativos, tratamento de vulnerabilidades e resposta a incidentes. Essas orientações podem servir como referência, embora sua aplicabilidade jurídica dependa da jurisdição e do contexto de cada organização. CISA+1
No Brasil, a aplicação de requisitos legais e regulatórios deve ser avaliada de acordo com o setor, a natureza do serviço e as normas pertinentes. A Lei Geral de Proteção de Dados Pessoais, por exemplo, pode ser relevante quando há tratamento de dados pessoais, mas não substitui os controles técnicos necessários para proteger sistemas industriais.
A gestão de riscos deve relacionar ameaças, vulnerabilidades, consequências, controles existentes e medidas de tratamento. Dessa maneira, a administração consegue compreender por que determinada iniciativa é prioritária e quais riscos permanecem após sua implantação.
Por fim, auditorias, exercícios de resposta e indicadores permitem verificar se as políticas estão sendo aplicadas na prática. Uma política formal sem evidências de execução oferece pouca garantia de que os riscos estejam efetivamente controlados.
Tabela comparativa de controles para infraestruturas críticas
A tabela a seguir relaciona medidas defensivas a seus objetivos e às principais precauções de implementação.
| Controle de segurança | Objetivo principal | Precaução necessária |
|---|---|---|
| Inventário de ativos | Identificar equipamentos e dependências | Atualizar informações e responsáveis |
| Segmentação de redes | Limitar comunicações entre ambientes | Validar fluxos essenciais antes das mudanças |
| Autenticação multifator | Reforçar a verificação de identidade | Planejar contingências e recuperação de acesso |
| Gestão de vulnerabilidades | Priorizar falhas e correções | Testar mudanças antes da implantação |
| Monitoramento de rede | Detectar desvios e incidentes | Considerar o comportamento normal da operação |
| Proteção de registros | Apoiar investigação e auditoria | Restringir alterações e sincronizar horários |
| Backups protegidos | Apoiar a recuperação de dados | Testar restaurações e controlar acessos |
| Plano de resposta | Coordenar decisões durante incidentes | Definir responsáveis e critérios de acionamento |
| Gestão de fornecedores | Reduzir riscos de terceiros | Revisar acessos, contratos e dependências |
| Treinamento operacional | Melhorar prevenção e resposta | Realizar exercícios compatíveis com as funções |
Entretanto, nenhum controle isolado garante proteção completa. A eficácia depende da combinação entre medidas técnicas, processos administrativos, treinamento e supervisão contínua.
EXEMPLO PRÁTICO: monitoramento seguro de alertas em uma infraestrutura crítica
Imagine uma equipe de segurança responsável por acompanhar os registros de um ambiente de tecnologia operacional. Para fins didáticos, ela precisa identificar eventos que ultrapassem um limite definido e produzir um alerta para avaliação humana.
Alerta de segurança: execute o exemplo somente em um ambiente de testes autorizado, previamente destinado a essa finalidade e sob sua inteira responsabilidade. Utilize dados fictícios, não conecte o programa a controladores industriais reais e não o empregue para emitir comandos sobre equipamentos físicos. O código demonstra uma lógica básica de classificação; não constitui uma ferramenta de segurança industrial pronta para produção.
O exemplo utiliza três níveis de prioridade: informativo, atenção e crítico. Em um sistema real, esses níveis precisariam ser definidos com base em critérios documentados, contexto operacional e procedimentos aprovados.
Exemplo 1 — Python: classificação defensiva de eventos
from dataclasses import dataclass@dataclassclass Evento: origem: str descricao: str severidade: intdef classificar_evento(evento: Evento) -> str: if not 0 <= evento.severidade <= 10: raise ValueError("A severidade deve variar de 0 a 10.") if evento.severidade >= 8: return "CRITICO" if evento.severidade >= 5: return "ATENCAO" return "INFORMATIVO"eventos = [ Evento("sensor-lab-01", "Registro normal", 2), Evento("gateway-teste-02", "Desvio observado", 6), Evento("servidor-lab-03", "Alerta prioritario", 9),]for evento in eventos: nivel = classificar_evento(evento) print(f"{nivel}: {evento.origem} - {evento.descricao}")Nesse programa, a função classificar_evento recebe um evento e devolve uma categoria. A validação impede que valores fora do intervalo previsto sejam aceitos silenciosamente. Além disso, os dados utilizados são fictícios e não existe conexão com sistemas industriais.
A classificação é intencionalmente simples. Em uma implementação real, a equipe precisaria considerar a confiabilidade da fonte, a criticidade do ativo, a correlação entre registros e o processo formal de escalonamento.
Exemplo 2 — Java: validação de eventos de segurança
public class MonitoramentoSeguro {

    static String classificar(int severidade) {
        if (severidade < 0 || severidade > 10) {
            throw new IllegalArgumentException(
                "A severidade deve variar de 0 a 10."
            );
        }

        if (severidade >= 8) {
            return "CRITICO";
        }

        if (severidade >= 5) {
            return "ATENCAO";
        }

        return "INFORMATIVO";
    }

    public static void main(String[] args) {
        int[] eventosDeTeste = {2, 6, 9};

        for (int evento : eventosDeTeste) {
            System.out.println(
                "Severidade " + evento + ": "
                + classificar(evento)
            );
        }
    }
}
De maneira semelhante, a versão em Java utiliza uma função que verifica os limites do valor recebido. Entretanto, o exemplo não implementa armazenamento, autenticação ou integração com dispositivos reais. Seu propósito é demonstrar uma regra de classificação que pode ser avaliada isoladamente em testes.
Exemplo 3 — JavaScript: apresentação de um alerta
"use strict";

function classificarEvento(severidade) {
  if (
    !Number.isInteger(severidade) ||
    severidade < 0 ||
    severidade > 10
  ) {
    throw new Error("Valor de severidade inválido.");
  }

  if (severidade >= 8) return "CRITICO";
  if (severidade >= 5) return "ATENCAO";
  return "INFORMATIVO";
}

const eventos = [
  { origem: "laboratorio-01", severidade: 2 },
  { origem: "laboratorio-02", severidade: 6 },
  { origem: "laboratorio-03", severidade: 9 }
];

for (const evento of eventos) {
  console.log(
    `${classificarEvento(evento.severidade)}: ${evento.origem}`
  );
}
Nesse caso, o JavaScript demonstra como classificar dados fictícios e apresentar os resultados no console. Assim, o desenvolvedor pode verificar a lógica sem executar ações sobre uma infraestrutura real.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL.
Revisão dos códigos: os três exemplos foram revisados quatro vezes quanto à estrutura, às condições de classificação, à validação de entradas e à coerência com o objetivo didático. Essa revisão não substitui testes automatizados, análise de segurança ou validação por profissionais responsáveis pelo ambiente de destino.
Exemplo adicional: banco de dados e painel local de alertas
Quando o volume de registros cresce, armazenar eventos em arquivos isolados pode dificultar pesquisas, auditorias e relatórios. Portanto, um banco de dados permite organizar informações, aplicar critérios de consulta e preservar um histórico estruturado.
Para um protótipo local, o SQLite pode ser suficiente, pois é um banco relacional que armazena dados em um arquivo e utiliza SQL. Já ambientes com múltiplos serviços, elevada concorrência ou requisitos operacionais mais rigorosos podem exigir uma solução como PostgreSQL ou outra plataforma adequada à arquitetura.
Em cenários de grande escala, a escolha depende do volume, da taxa de gravação, da retenção, da disponibilidade e dos requisitos de recuperação. Bancos não relacionais também podem ser apropriados em determinados casos, mas não são automaticamente melhores apenas porque existem muitos registros.
A seguir, o backend utiliza Python e SQLite para registrar eventos fictícios. O frontend utiliza HTML, CSS e JavaScript para consultar os registros em localhost. O protótipo não se conecta a equipamentos industriais e não deve ser exposto à internet sem uma arquitetura de segurança apropriada.
Backend em Python — app.py
Instale o Flask em um ambiente virtual de desenvolvimento autorizado:
python -m venv .venvAtive o ambiente virtual conforme o sistema operacional e instale a dependência:
python -m pip install flaskCódigo do servidor:
import sqlite3from pathlib import Pathfrom flask import Flask, jsonify, requestapp = Flask(__name__)BANCO = Path(__file__).with_name("eventos.db")def conectar(): conexao = sqlite3.connect(BANCO) conexao.row_factory = sqlite3.Row return conexaodef preparar_banco(): with conectar() as db: db.execute(""" CREATE TABLE IF NOT EXISTS eventos ( id INTEGER PRIMARY KEY AUTOINCREMENT, origem TEXT NOT NULL, descricao TEXT NOT NULL, severidade INTEGER NOT NULL CHECK (severidade BETWEEN 0 AND 10) ) """)@app.get("/api/eventos")def listar_eventos(): with conectar() as db: linhas = db.execute(""" SELECT id, origem, descricao, severidade FROM eventos ORDER BY id DESC LIMIT 100O código utiliza parâmetros nas consultas SQL para evitar a montagem de comandos a partir de valores fornecidos pelo usuário. Além disso, limita a quantidade de registros retornados e valida os campos recebidos.
Contudo, o protótipo não implementa autenticação, autorização, proteção contra abuso de requisições ou política de retenção. Por isso, não deve ser considerado um serviço pronto para produção. A aplicação deve ser executada apenas em um ambiente de desenvolvimento isolado, com dados de teste.
Frontend em HTML, CSS e JavaScript — index.html
<!DOCTYPE html>
<html lang="pt-BR">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>Painel local de eventos</title>

  <style>
    body {
      font-family: Arial, sans-serif;
      max-width: 850px;
      margin: 2rem auto;
      padding: 0 1rem;
      background: #f4f6f8;
      color: #17212b;
    }

    section {
      padding: 1rem;
      margin-bottom: 1rem;
      background: white;
      border-radius: 8px;
    }

    label, input, textarea, button {
      display: block;
      width: 100%;
      margin-top: 0.5rem;
      box-sizing: border-box;
    }

    input, textarea, button {
      padding: 0.7rem;
    }

    button {
      cursor: pointer;
    }

    li {
      margin-bottom: 0.8rem;
    }
  </style>
</head>

<body>
  <h1>Painel local de eventos</h1>

  <section>
    <h2>Registrar evento fictício</h2>

    <form id="formulario">
      <label for="origem">Origem</label>
      <input id="origem" maxlength="80" required>

      <label for="descricao">Descrição</label>
      <textarea id="descricao" maxlength="300" required></textarea>

      <label for="severidade">Severidade (0 a 10)</label>
      <input id="severidade" type="number"
             min="0" max="10" step="1" required>

      <button type="submit">Registrar</button>
    </form>

    <p id="mensagem" role="status"></p>
  </section>

  <section>
    <h2>Últimos eventos</h2>
    <button id="atualizar">Atualizar lista</button>
    <ul id="eventos"></ul>
  </section>

  <script>
    const formulario = document.querySelector("#formulario");
    const mensagem = document.querySelector("#mensagem");
    const lista = document.querySelector("#eventos");

    async function carregarEventos() {
      const resposta = await fetch("/api/eventos");

      if (!resposta.ok) {
        throw new Error("Não foi possível consultar os eventos.");
      }

      const eventos = await resposta.json();
      lista.replaceChildren();

      for (const evento of eventos) {
        const item = document.createElement("li");

        // textContent evita interpretar descrições como HTML.
        item.textContent =
          `#${evento.id} | ${evento.origem} | ` +
          `${evento.descricao} | Severidade: ${evento.severidade}`;

        lista.appendChild(item);
      }
    }

    formulario.addEventListener("submit", async (evento) => {
      evento.preventDefault();
      mensagem.textContent = "";

      const dados = {
        origem: document.querySelector("#origem").value.trim(),
        descricao: document.querySelector("#descricao").value.trim(),
        severidade: Number(
          document.querySelector("#severidade").value
        )
      };

      try {
        const resposta = await fetch("/api/eventos", {
          method: "POST",
          headers: { "Content-Type": "application/json" },
          body: JSON.stringify(dados)
        });

        if (!resposta.ok) {
          throw new Error("Dados rejeitados pelo servidor.");
        }

        mensagem.textContent = "Evento de teste registrado.";
        formulario.reset();
        await carregarEventos();
      } catch (erro) {
        mensagem.textContent = erro.message;
      }
    });

    document.querySelector("#atualizar").addEventListener(
      "click",
      async () => {
        try {
          await carregarEventos();
          mensagem.textContent = "Lista atualizada.";
        } catch (erro) {
          mensagem.textContent = erro.message;
        }
      }
    );

    carregarEventos().catch((erro) => {
      mensagem.textContent = erro.message;
    });
  </script>
</body>
</html>
Para executar o protótipo, salve o arquivo HTML na pasta static e acrescente ao backend a configuração correspondente para servir esse diretório. Depois, abra a aplicação pelo endereço local do Flask, em vez de abrir o arquivo HTML diretamente, pois as chamadas fetch dependem de uma origem HTTP compatível.
Em um sistema real, seriam necessários autenticação, autorização, proteção contra requisições indevidas, registro de auditoria, gerenciamento de segredos, tratamento de erros e testes de segurança. Além disso, a interface deve respeitar as permissões do usuário e não apresentar informações operacionais sensíveis sem necessidade.
ATENÇÃO – SE FOR UTILIZAR OS CÓDIGOS TENHA CUIDADO E ATENÇÃO E SEJA RESPONSÁVEL.
Revisão do código com banco de dados: o backend e o frontend foram revisados quatro vezes quanto à validação das entradas, ao uso de parâmetros SQL, ao tratamento básico de erros e à separação entre apresentação e armazenamento. Ainda assim, é indispensável executar testes locais, verificar as dependências e realizar uma avaliação de segurança antes de qualquer uso além do protótipo.
Você também pode se interessar por: https://digitalterritory.com.br/engenharia-reversa-e-analise-profunda-de-sistemas/
Fluxograma: funcionamento de uma estratégia de cibersegurança avançada
O funcionamento de um programa de proteção pode ser representado como um ciclo contínuo. Dessa maneira, a organização evita tratar a segurança como uma atividade pontual e passa a integrar avaliação de riscos, prevenção, detecção, resposta e melhoria.
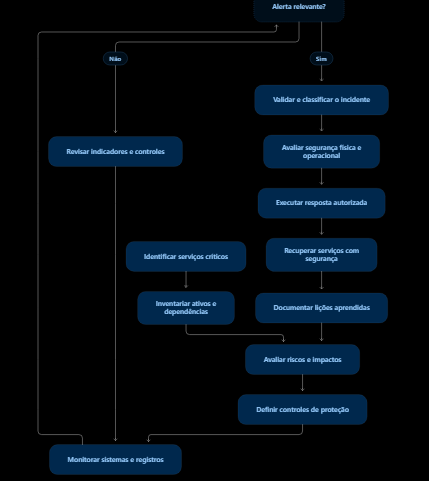
Primeiramente, a organização identifica os serviços que precisam ser preservados. Em seguida, relaciona os ativos e avalia os riscos associados. Com base nessa análise, seleciona controles compatíveis com a operação e estabelece mecanismos de monitoramento.
Quando surge um alerta, a equipe verifica sua relevância e avalia os possíveis impactos antes de executar uma resposta autorizada. Finalmente, após a recuperação, os resultados são documentados e utilizados para aperfeiçoar o programa.
Portanto, o fluxograma demonstra que a cibersegurança avançada para infraestruturas críticas depende de um processo recorrente, no qual cada etapa alimenta a seguinte.
Gráficos e vetores conceituais para análise de risco
A gestão de riscos também pode ser representada por modelos matemáticos simplificados. Embora não substituam métodos formais, esses modelos ajudam a explicar como as decisões de segurança podem ser organizadas.
Gráfico conceitual 1: investimento em proteção e risco residual
Considere o eixo \(x\) como o nível de implementação de controles e o eixo \(y\) como o risco residual estimado. Para fins ilustrativos, podemos utilizar a função:
\[ R(x)=\frac{100}{1+0{,}15x} \]
Nessa expressão, \(x\) representa um índice hipotético de maturidade dos controles, e \(R(x)\) corresponde a um índice ilustrativo de risco residual. Os valores não representam estatísticas reais de uma infraestrutura específica.
Maturidade dos controles e risco residual ilustrativo
Modelo conceitual: o risco estimado diminui à medida que a maturidade dos controles aumenta; não representa dados reais.
0 pontos25 pontos50 pontos75 pontos100 pontos0246810
O modelo sugere uma redução progressiva do risco estimado, embora os benefícios de controles reais dependam da implementação, da qualidade dos processos e das ameaças existentes. Assim, não se deve interpretar a função como uma previsão quantitativa universal.
Gráfico conceitual 2: prioridade de tratamento
Outra representação considera a relação entre a probabilidade estimada de um incidente e seu impacto potencial. Nesse caso, uma aproximação simples é:
\[ P = L \times I \]
Em que \(L\) representa um índice de probabilidade, \(I\) representa um índice de impacto e \(P\) corresponde a uma pontuação de prioridade. Se ambos os índices variarem de 1 a 5, a pontuação será de 1 a 25.
Por exemplo, um cenário com probabilidade estimada igual a 4 e impacto igual a 5 apresenta pontuação 20. Entretanto, essa pontuação não deve ser interpretada isoladamente: um risco relacionado à segurança humana pode exigir prioridade especial, mesmo quando a estimativa numérica for incerta.
Vetores de decisão em cibersegurança
Uma análise mais completa pode representar cada cenário por um vetor:
\[ \vec{v}=(C,I,D,S,R) \]
Nesse modelo conceitual:
- \(C\): confidencialidade;
- \(I\): integridade;
- \(D\): disponibilidade;
- \(S\): segurança física e operacional;
- \(R\): capacidade de recuperação.
Cada dimensão pode receber uma avaliação segundo critérios definidos pela organização. Assim, dois ativos com a mesma importância financeira podem apresentar prioridades diferentes quando um deles influencia diretamente um processo essencial.
Consequentemente, os vetores ajudam a evitar decisões baseadas em um único indicador. Uma arquitetura realmente resiliente precisa equilibrar proteção dos dados, continuidade dos serviços, segurança física e capacidade de recuperação.
Indicadores para medir a maturidade da segurança
Uma estratégia precisa de indicadores para verificar se os controles estão funcionando. Entretanto, medir apenas a quantidade de ferramentas instaladas ou de alertas gerados pode produzir uma visão incompleta.
Entre os indicadores úteis estão:
- Percentual de ativos críticos inventariados e com responsáveis definidos.
- Tempo entre a identificação e a avaliação de um alerta relevante.
- Percentual de vulnerabilidades prioritárias tratadas dentro do prazo estabelecido.
- Quantidade de acessos privilegiados revisados conforme a política interna.
- Percentual de restaurações de backup concluídas com sucesso nos testes.
- Tempo de recuperação observado durante exercícios autorizados.
- Percentual de fornecedores críticos submetidos a avaliações de segurança.
- Número de exercícios de resposta realizados e de melhorias concluídas.
Além disso, cada indicador deve possuir uma definição consistente, uma fonte de dados e um responsável. Caso contrário, comparações entre períodos podem gerar conclusões equivocadas.
Por exemplo, o aumento de alertas não significa necessariamente que a segurança piorou. Ele pode resultar de um monitoramento mais abrangente. Por conseguinte, os resultados precisam ser interpretados considerando as mudanças na cobertura, nos processos e no ambiente operacional.
A maturidade deve ser avaliada pela capacidade de reduzir riscos e manter serviços seguros, e não apenas pela quantidade de controles adquiridos.
Erros comuns na proteção de infraestruturas críticas
Mesmo organizações com recursos tecnológicos podem cometer erros que reduzem a eficácia de suas estratégias.
Um erro frequente é aplicar mudanças sem compreender as dependências operacionais. Em ambientes industriais, uma atualização ou um bloqueio de comunicação pode afetar funções essenciais. Portanto, alterações precisam passar por avaliação de impacto, testes e aprovação dos responsáveis.
Outro problema é manter inventários desatualizados. Sem conhecer os equipamentos, suas versões e suas conexões, a equipe pode deixar ativos expostos fora do planejamento de proteção. Dessa maneira, o inventário deve acompanhar as alterações do ambiente.
Também é arriscado depender de um único mecanismo de defesa. Uma firewall, um antivírus ou um sistema de detecção pode falhar ou não abranger todos os cenários. Assim, a combinação de controles independentes tende a oferecer uma proteção mais consistente.
Por sua vez, backups nunca testados podem gerar uma falsa sensação de segurança. A existência de uma cópia não comprova que os dados estejam íntegros nem que a recuperação possa ocorrer dentro do prazo necessário.
Finalmente, a falta de exercícios de resposta pode deixar as equipes despreparadas para situações que exigem coordenação entre segurança, engenharia, administração e fornecedores. Por isso, o treinamento precisa fazer parte da rotina de gestão de riscos.
Tendências futuras da cibersegurança para infraestruturas críticas
Nos próximos anos, a integração entre inteligência artificial, automação, computação em nuvem e dispositivos industriais deverá ampliar tanto as oportunidades de inovação quanto a complexidade da proteção.
A análise automatizada pode acelerar a triagem de alertas, enquanto a arquitetura de confiança zero pode reforçar a verificação de identidades e conexões. Entretanto, esses recursos precisam ser adaptados aos requisitos de segurança e disponibilidade dos ambientes operacionais.
Outra tendência importante é a ampliação da visibilidade sobre ativos e dependências. Quanto melhor uma organização compreender sua arquitetura, mais condições terá de priorizar investimentos, avaliar fornecedores e responder a alterações inesperadas.
Além disso, a preparação para incidentes deverá receber atenção crescente. Exercícios, procedimentos de recuperação e mecanismos de comunicação ajudam a reduzir a dependência de decisões improvisadas.
O cenário tecnológico também exige atenção à evolução dos padrões criptográficos e à preparação para mudanças futuras. Contudo, iniciativas dessa natureza devem seguir avaliações técnicas e cronogramas adequados, sem comprometer a compatibilidade ou a continuidade operacional.
Em síntese, a tendência mais relevante não é a adoção de uma ferramenta isolada, mas a construção de uma capacidade permanente de adaptação. Organizações resilientes aprendem com incidentes, revisam seus controles e atualizam seus procedimentos conforme o ambiente muda.
Resumo: como construir uma infraestrutura digital resiliente
A cibersegurança avançada para infraestruturas críticas exige uma abordagem integrada, capaz de proteger informações, sistemas industriais e serviços essenciais contra falhas e ameaças digitais. Portanto, sua implementação deve começar pela identificação dos ativos, pelo entendimento das dependências e pela avaliação dos impactos que uma interrupção pode provocar.
Em seguida, a organização precisa estabelecer controles compatíveis com seus riscos. Segmentação de redes, autenticação robusta, monitoramento contínuo, gestão de vulnerabilidades, criptografia e avaliação de fornecedores contribuem para reduzir a exposição. Entretanto, esses recursos precisam ser acompanhados por procedimentos documentados e profissionais capacitados.
Além disso, a resposta a incidentes, os backups testados e os planos de continuidade permitem preparar a organização para situações adversas. A recuperação deve considerar a integridade dos sistemas e a segurança física, principalmente quando as tecnologias digitais influenciam processos reais.
Finalmente, governança, indicadores e exercícios periódicos ajudam a transformar a segurança em um processo de melhoria contínua. Dessa forma, a infraestrutura não depende apenas de prevenir todos os incidentes, mas também de reconhecer problemas, limitar seus efeitos e recuperar os serviços de maneira controlada.
NOTA TÉCNICA
Palavras-chave essenciais: cibersegurança avançada, infraestruturas críticas, tecnologia operacional (OT), sistemas SCADA, controladores PLC, segmentação de redes, defesa em profundidade, gestão de vulnerabilidades, autenticação multifator, monitoramento contínuo, inteligência artificial, resposta a incidentes, continuidade operacional, recuperação de desastres e gestão de riscos.
Conclusão
Em conclusão, proteger infraestruturas críticas significa preservar muito mais do que equipamentos e informações: significa manter a confiabilidade dos serviços que sustentam a sociedade. Por isso, a cibersegurança avançada precisa integrar tecnologia, engenharia, governança e preparação humana em uma estratégia coerente.
Embora as ferramentas modernas ofereçam recursos cada vez mais sofisticados, a eficácia depende de conhecer os ativos, controlar os acessos, compreender as dependências e testar os procedimentos de recuperação. Assim, organizações que adotam uma abordagem estruturada podem melhorar sua capacidade de prevenir incidentes, responder com responsabilidade e manter a continuidade de suas operações.
Portanto, investir em cibersegurança avançada para infraestruturas críticas representa uma decisão estratégica de longo prazo. Afinal, quanto maior a importância de um serviço para a sociedade, maior deve ser o compromisso com sua proteção, sua resiliência e sua recuperação segura.